MeasureCamp Bruxelles 2026 : où va l'industrie de la data ?
Aussi disponible enEnglish
MISE A JOUR: Vous avez assisté à ma session à MeasureCamp Bruxelles? Retrouvez ma session card à https://mc.analytics-debugger.com/v/46558 Vous y trouverez des détails, un lien vers la présentation en PDF, mais aussi de quoi voter pour ma session et laisser un commentaire!
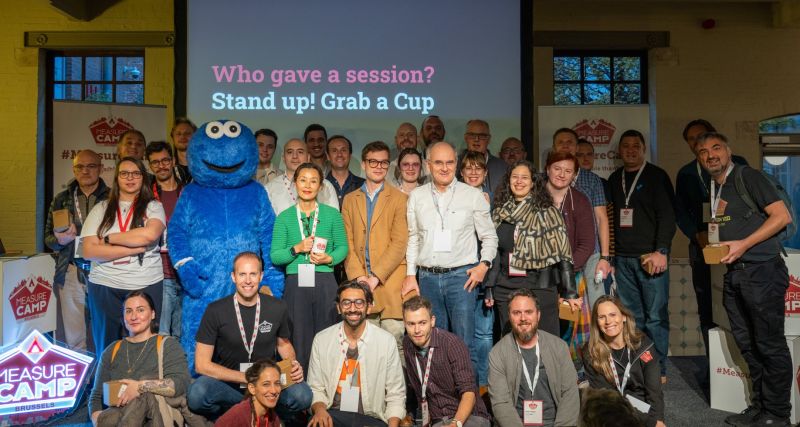
MeasureCamp Bruxelles a tenu sa septième édition le 14 novembre 2026 aux Ateliers des Tanneurs. Cinq salles, huit créneaux répartis entre le matin et l’après-midi, 39 sessions proposées le jour même. Personne ne pilote le programme d’un MeasureCamp : ce que les gens choisissent de proposer montre ce qui préoccupe la communauté.
Je n’ai évidemment pas pu assister à toutes les sessions. J’ai comparé mes notes avec des collègues qui publient sur l’événement, et j’ai posé des questions aux intervenants pendant les pauses café.
EN RÉSUMÉ : l’industrie ne se demande plus s’il faut utiliser l’IA. Elle exige avat tout des données fiables pour qu’on puisse lui faire confiance. De nombreux autres thèmes sont en fait des variations sur cette problémarique.
L’IA est partout, et le rôle de l’analyste reste un mystère
L’IA a été de loin le thème dominant. Peu de sessions du style « regardez ce que fait cet outil ». La plupart parlaient de gens et de pratiques.
Krista Seiden (« Full Throttle Analytics ») décrivait une industrie analytics qui passe de « ce qui s’est passé » à « pourquoi », puis à « que faire ensuite ». Le travail de l’analyste glisse de la construction de dashboards vers l’interprétation des comportements et des intentions. Ivan Burban abordait le versant organisationnel : comment un usage d’agents IA qui fonctionne pour une équipe devient une pratique d’entreprise, avec phases de déploiement, responsables, contexte partagé et garde-fous.
Jim Kultgen ouvrait avec un sondage en direct sur les usages réels de l’IA en analytics, un bon contrôle face à l’image des « 5 Mac minis et d’un essaim d’agents » vue sur les réseaux sociaux. Marie Fenner (« Partnering With AI ») a fait le lien entre des exemples de résultats d’IA insultants et d’autres éclairants, comme quoi le contrôle qualité fait désormais partie du métier. Hussain Mehmood, de Marketlytics, a posé la question « What Good Is A Human? », et Johan Terpstra est allé plus loin avec « AI Identity Crisis » sur la société, l’économie et la santé mentale. Yael Farkas a examiné comment l’IA va augmenter le travail humain via chatbots et personnalisation, tandis que Jean-Marc Courtiade à montré comment il s’est « cloné » pour automatiser ses tâches répétitives.
Aristide Riou a (encore) été brilliant. Lassé comme beaucoup de l’interface de Google Analytics, il en a reconstruit une avec BigQuery et un assistant de code IA.
Dans ces sessions, l’IA est un collègue qu’on encadre et dont on lit les résultats d’un œil critique. Personne ne l’a présenté comme une fonctionnalité à activer mais bien comme un outil qui doit être présent dans notre attirail de digital analyst.
Documentation, couches sémantiques et données agent-ready
C’était le consensus technique le plus net de la journée : un agent IA ne vaut que grâce au contexte qu’on lui donne.
Piotr Gruszecki (« Semantic Model For Conversational Analytics ») soutenait que les couches sémantiques sont devenues indispensables parce que les agents IA ne peuvent pas fonctionner sans. Il montrait comment en bâtir une pour Google Search Console, GA4 et les plateformes publicitaires avec Claude Code, Codex, Terraform, Schemachange et Snowflake. Tijs Van Autreve faisait le même constat côté documentation : l’analytics assistée par IA ne fonctionne qu’avec la bonne documentation, et il voulait comparer ce que chaque équipe documente.
Ma propre session, « Analytics As Code » (Julien Coquet), défend l’idée qu’un plan de marquage a sa place dans Git, versionné, relisible et traçable, avec une gouvernance en YAML. Une source de vérité lisible par les machines sert autant les humains que les agents.
Retrouvez ma présentation “Analytics as Code” en PDF
Lukas Cech a abordé le self-service analytics avec « plus de questions que de réponses ». Maria Shcherbyna et Ivan Burban ont comparé la façon dont agences et équipes internes répondent aujourd’hui aux questions data : dashboards, tableurs ou chat IA.
Documentation, plans de marquage et modèles sémantiques passaient pour une grosse charge de travail parfois ignorée. Au cours de ce MeasureCamp, ils apparaissent clairement comme l’interface entre vos données et votre IA.
Qualité du tracking et infrastructure server-side
Sous le discours sur l’IA, une inquiétude plus ancienne : les données sont-elles seulement justes ?
Adrienne Vermorel (« Green Checks, Wrong Data ») détaillait quatre pièges de tracking et un incident de lancement réel, ainsi que ce qu’il faut vérifier avant de déclarer un travail terminé, y compris celui réalisé par des agents IA. Mariusz Brucki rappelait qu’environ 400 millions de personnes utilisent des bloqueurs de publicité capables d’empêcher le chargement d’une plateforme de gestion du consentement, et montrait quelles CMP sont bloquées et comment y remédier.
David Vallejo présentait TagRipper, un outil open source pour tester les dispositifs server-side. Niek Schlepers partageait six mois de données de requêtes sur qui explore l’infrastructure GTM, avec les bugs trouvés dans sa propre détection de bots. Robert Petković faisait une démo en direct des nouvelles balises Google dans GTM en environnement multi-domaines.
Le server-side est assez répandu pour exiger ses propres pratiques de test, de sécurité et de supervision.
Vie privée et réglementation, avec humour
La conformité occupait deux sessions conçues en tandem, avec beaucoup de participation du public. Nicolas Malo et Fabrizio Bianchi mettaient en scène le « GDPR/AI Waffle Court », un procès de deux stacks analytics avec le public pour jury. Fabrizio Bianchi enchaînait avec « The Blue Slides » : la refonte européenne des règles sur les cookies, le report des échéances de l’AI Act, le Data Privacy Framework et les conséquences des bouleversements politiques à la FTC américaine.
Fanny Marcoux proposait une définition de la donnée éthique en six piliers, et Lucie Lafarge et Rebecca Tavel présentaient un cadre de gouvernance réutilisable centré sur le risque.
Les règles bougent sans cesse (cookies, AI Act, transferts), donc les équipes veulent des cadres partagés et des réponses rodées plus que des audits ponctuels.
Mesure : du clic à la marge, aux contrats signés et à l’incrémentalité
Les sessions de mesure avaient un fil commun : cesser de donner aux plateformes publicitaires la métrique facile.
Olivier Guillaume, de QUANTI, proposait d’envoyer la marge nette plutôt que le chiffre d’affaires à Google Ads et Meta, pour passer d’un pilotage au ROAS à un pilotage au POAS. Les coûts viennent de l’ERP, la marge est calculée dans l’entrepôt de données, et le server-side la renvoie aux plateformes. Antoine Brion (LinkedIn) appliquait la même logique à la génération de leads. Les étapes CRM et la valeur des contrats signés repartent en conversions hors ligne via Enhanced Conversions for Leads et la Conversions API, pour enchérir sur les contrats et plus sur les formulaires. Antoine Tissier alertait : des A/B tests optimisés uniquement sur la conversion au paiement laissent annulations et retours grignoter la marge.
Francesco Schena animait une table ronde MMM. Jonathan Thompson, de Google, montrait comment tests géographiques et modèles de mix marketing se complètent, avec Meridian, l’outil open source de Google. Ellie Hughes (LinkedIn) demandait combien de données un test requiert pour répondre aux parties prenantes avec rigueur, et Juliana Jackson partageait ce que lui a appris le test de centaines de créations pour 75 grandes marques sur YouTube Ads. Tim Ceuppens (« Value Creation vs Discounting ») s’interrogeait sur la raison pour laquelle les remises fonctionnent et abîment lentement une entreprise.
Les résultats business (marge, contrats signés, incrémentalité) remplacent les proxys des plateformes, et la tuyauterie nécessaire est en first-party, server-side et compatible avec le consentement.
Équipes data, impact et réalité des organisations
Un groupe de sessions plus discret demandait pourquoi une bonne analyse ne change toujours pas les décisions.
Michel Bieze partageait quatre leçons pour passer du reporting à l’action, afin que les analyses ne finissent pas au fond d’un tiroir. Steen Rasmussen (« Decision Laundering ») s’appuyait sur les réponses de 300 analystes pour montrer comment les organisations utilisent, et détournent, les données que les analystes leur livrent. Yael Farkas, Juliana Jackson et Peter O’Neill animaient « No Stupid Questions » entre juniors et seniors, et Peter O’Neill proposait « Analytics Therapy », un espace sûr pour exprimer ses frustrations.
Alexandra Augusti et Fosca Fimiani discutaient des CDP, de l’absence de CDP au composable, et du choix entre construire et acheter. Sebastien Monnier et Morgan Bouvet montraient comment exposer ses données à moindre coût sur GCP, des dashboards aux vidéos personnalisées. Maissa Larbi animait un débat sur l’IA, l’analytics et la data après une panne Microsoft.
À mesure que l’outillage s’automatise, ce qui différencie les analystes, c’est l’influence, le jugement et la maîtrise de leur propre stack.
Et une rave de données
Francesco Schena transformait des données Google Analytics en techno dans « The Data Rave ». L’algorave, de la musique dance produite en live coding, est un de mes sujets de prédilection, donc celle-ci m’a fait plaisir. Si la curiosité vous prend, allez voir Strudel, un environnement de live coding dans le navigateur, ainsi que des artistes comme DJ Dave et Switch Angel sur YouTube et les réseaux sociaux.
Ce que le programme dit de la direction
- Le contexte est le nouveau goulot d’étranglement. Couches sémantiques, documentation et plans de marquage as code figuraient parmi les sujets les plus concrets du programme.
- Vérifier compte plus qu’automatiser. Les voyants verts trompeurs, les sorties d’IA insultantes et le « decision laundering » pointent la même compétence.
- On doit renvoyer de la valeur aux plateformes, pas du volume. Marge et contrats signés passent par des pipelines server-side, consentement géré.
- La conformité continue de bouger, et on l’aborde avec des cadres partagés et de l’humour.
- Le métier d’analyste se redéfinit : de la production de dashboards vers l’interprétation, la décision et l’influence.
L’industrie troque les dashboards contre des données documentées, gouvernées et fiables que les machines peuvent exploiter, et cherche encore ce qu’il reste aux humains. La réponse du programme : le jugement, la communication et le soin.
Les fiches de sessions (titres, intervenants et résumés) restent consultables sur le tableau des sessions de MeasureCamp Bruxelles 2026.
On se retrouve l’an prochain ! Consultez le calendrier des MeasureCamp pour les prochaines éditions. Si la ville la plus proche est trop loin de chez vous, n’hésitez pas à lancer la vôtre !